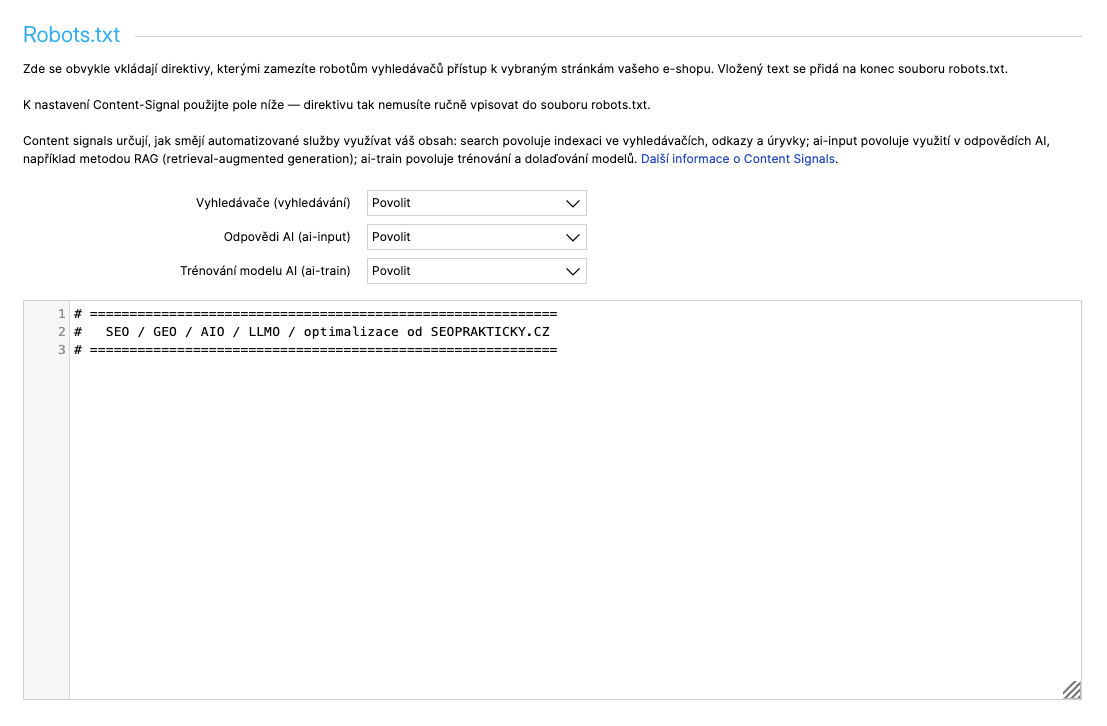
Content Signals jsou řádek v souboru robots.txt, kterým provozovatel webu sděluje, k čemu smějí automatizované služby jeho obsah použít: pro vyhledávání (search), jako podklad pro odpovědi AI (ai-input) a pro trénování AI modelů (ai-train). Shoptet je nově umožňuje nastavit třemi rozbalovacími poli přímo v administraci, takže je nemusíte do robots.txt psát ručně.
Pro e-shop jde o rozhodnutí, které může stát peníze jen jedním směrem: kdo omylem nastaví „Nepovolit“ u odpovědí AI, posílá světu signál, že v ChatGPT ani v AI Overviews být nechce — tedy přesně tam, kde se dnes zákazníci ptají, co koupit. Zároveň je potřeba říct na rovinu, že žádný velký vyhledávač ani AI firma zatím veřejně nepotvrdili, že se těmito signály řídí. Níže najdete, co jednotlivé volby znamenají, jaké nastavení doporučujeme a co AI roboty skutečně řídí.
Co v článku najdete
- Co Content Signals umí a co ne
- Tři signály a co přesně znamenají
- Povolit, Nepovolit, Nenastaveno: co se propíše
- Kdo se signály řídí
- Naše doporučení: jak je nastavit
- Co platí a co doložit nejde
- Co AI roboty skutečně řídí
- Nastavení a kontrola ve 4 krocích
- Nejčastější chyby z našich auditů
- Časté dotazy
Co Content Signals umí a co ne
Content Signals fungují jako cedulka „Fotografovat zakázáno“ ve výloze obchodu. Slušný kolemjdoucí ji respektuje, ale fotoaparát vám nikdo nevezme. A pokud cedulka visí v jazyce, kterému většina kolemjdoucích nerozumí, nemá skoro žádný účinek — což je u Content Signals zatím přesně ten případ.
Co Content Signals umí
Signál- +Vyjádřit, k jakému účelu obsah použít smí a nesmí
- +Rozlišit vyhledávání, odpovědi AI a trénink modelů
- +Zaznamenat vaši vůli strojově čitelnou formou
Co Content Signals neumí
Limity- −Zablokovat robota — přístup na web řídí jiné řádky robots.txt
- −Přinutit kohokoli, aby se jimi řídil
- −Zlepšit pozice ve vyhledávání nebo viditelnost v AI
„Nepovolit“ u odpovědí AI je pro e-shop vlastní gól
Hodnota ai-input=no říká, že váš obsah nemá sloužit jako podklad pro odpovědi AI — tedy pro ChatGPT, Perplexity nebo AI Overviews. Dnes ji velké systémy podle dostupných informací nerespektují, takže škoda zatím nevzniká. Kdyby ji ale začaly respektovat, e-shop by z AI doporučení vypadl a nikdo by vás na to neupozornil. Pokud nemáte placený nebo důvěrný obsah, tuhle volbu nepoužívejte.
Tři signály a co přesně znamenají
Content Signals zavedl Cloudflare v září 2025 jako součást svého Content Signals Policy. Definice jsou užší, než naznačují popisky v administraci — zejména u vyhledávání.
| Signál | Pole v Shoptetu | Co povoluje nebo zakazuje |
|---|---|---|
| search | Vyhledávače (vyhledávání) | Zařazení do vyhledávacího indexu a zobrazení odkazu s krátkým úryvkem. Podle definice Cloudflare sem nepatří AI shrnutí ve výsledcích. |
| ai-input | Odpovědi AI (ai-input) | Použití obsahu jako podkladu pro odpověď AI v reálném čase — metodou RAG nebo groundingu. Sem spadají odpovědi ChatGPT s vyhledáváním, Perplexity i AI Overviews. |
| ai-train | Trénování modelu AI (ai-train) | Použití obsahu k trénování nebo doladění AI modelů. Na to, co AI odpoví dnes, nemá vliv — týká se budoucích verzí modelů. |
Z rozdělení plyne důležitá věc: „Povolit“ u vyhledávačů samo o sobě nepokrývá AI shrnutí ve výsledcích. Kdo chce být v AI odpovědích, musí mít povolený i ai-input.
Povolit, Nepovolit, Nenastaveno: co se propíše
Každé pole má tři volby. Shoptet podle nich sestaví jediný řádek Content-Signal a přidá ho do robots.txt.
| Volba v Shoptetu | Co se propíše | Co tím říkáte |
|---|---|---|
| Povolit | signál=yes | Výslovně souhlasíte s tímto použitím obsahu. |
| Nepovolit | signál=no | Výslovně nesouhlasíte. Pro trénink AI to Cloudflare rámuje i jako výhradu práv. |
| Nenastaveno | Hodnota v řádku chybí | Nevyjadřujete žádnou preferenci — ani souhlas, ani zákaz. Když jsou nenastavená všechna tři pole, řádek zmizí celý. |
robots.txt — ukázky výsledného řádku
Řádek nic neblokuje. Roboti se na web dostanou podle pravidel User-agent, Allow a Disallow bez ohledu na to, co v něm stojí.
Kdo se signály řídí
Tohle je pro rozhodování nejdůležitější sekce. Signál má smysl jen tehdy, když ho ten, komu je určen, čte a řídí se jím.
| Služba | Stav k říjnu 2026 |
|---|---|
| Oficiální specifikace robots.txt uvádí, že parser ignoruje všechna pravidla kromě allow, disallow a user-agent. Řádek Content-Signal tedy nečte. | |
| Bing | Podporu veřejně neohlásil. |
| OpenAI, Anthropic, Perplexity | Podporu veřejně neohlásili. Pro řízení přístupu publikují vlastní názvy robotů, které se zadávají v pravidlech User-agent. |
| Cloudflare | Autor standardu. Pro weby se spravovaným robots.txt ve výchozím stavu zapisuje search=yes, ai-train=no. |
John Mueller z Googlu se k tomu v létě 2026 vyjádřil na Redditu velmi přímo:
Nemá to žádný účinek na žádného crawlera ani jazykový model.
Zdroj: John Mueller (Google) na Redditu, podle Search Engine Roundtable, červenec 2026 (vlastní překlad)
Souběžně ale běží standardizace. Pracovní skupina IETF pro AI preference připravuje společný slovník se kategoriemi trénink AI, použití v AI a vyhledávání. Návrh zatím nemá konsenzus, ale ukazuje, kam se obor posouvá. Pokud se standard prosadí, signály v robots.txt mohou začít fungovat — a nastavení, které si dnes zvolíte, se pak začne počítat.
Naše doporučení: jak je nastavit
Rozhodnutí stojí na jediné otázce: chcete, aby vás AI nástroje doporučovaly? Pro naprostou většinu e-shopů na Shoptetu je odpověď ano. Zákazník se v ChatGPT ptá, kde koupit, a odpověď skládá z obsahu, ke kterému AI smí.
| Typ webu | Vyhledávače | Odpovědi AI | Trénování AI |
|---|---|---|---|
| E-shop | Povolit | Povolit | Povolit |
| Služby, B2B, výrobce | Povolit | Povolit | Povolit |
| Vydavatel s autorským obsahem (magazín, odborné články, vlastní výzkum) | Povolit | Povolit | Nepovolit |
| Placený nebo důvěrný obsah | Povolit | Nepovolit | Nepovolit |
Proč u e-shopu povolit i trénování. Trénovací data určují, co model „ví“ bez vyhledávání: jaké značky v oboru zná a s čím si je spojuje. Pro e-shop, který chce být v doporučeních, je to výhoda, ne ztráta. Obsah produktových stránek navíc není dílo, které by konkurence nemohla napsat sama. Zákaz trénování dává smysl tam, kde je hodnotou samotný text — vlastní výzkum, odborné články, data.
Co nikdy: „Nepovolit“ u vyhledávačů a u odpovědí AI, pokud nemáte obsah za přihlášením. Obě volby jdou přímo proti tomu, proč web provozujete.
„Nenastaveno“ není chyba
Dokud signály nikdo velký nečte, mezi „Povolit“ a „Nenastaveno“ není měřitelný rozdíl. Povolit doporučujeme proto, že jednoznačně vyjadřuje vaši vůli pro případ, že se standard prosadí. Kdo chce mít robots.txt co nejkratší, nic nezkazí ani volbou Nenastaveno.
Co platí a co doložit nejde
Co platí. Google podle své dokumentace řádek Content-Signal ignoruje a jeho zástupce potvrdil, že na žádný crawler nemá účinek. Žádná z velkých AI firem podporu veřejně neohlásila. Přístup na web řídí pravidla User-agent, Allow a Disallow. Český autorský zákon v § 39c umožňuje vytěžování textů a dat i pro komerční účely, pokud si autor tento způsob užití nevyhradí — a výhrada musí mít strojově čitelnou podobu.
Co doložit nejde. Zda hodnota ai-train=no v řádku Content-Signal splňuje požadavek strojově čitelné výhrady podle § 39c, zatím žádný soud neposuzoval. Cloudflare ji tak rámuje, ale výklad je otevřený. Nedoložené je i opačné tvrzení, že signály nemají a nikdy nebudou mít žádný význam — standardizace v IETF pokračuje. A nikdo nedoložil, že by povolení signálů zlepšilo viditelnost v AI odpovědích.
Praktický závěr platí bez ohledu na vývoj: signály nastavte tak, aby odpovídaly vaší skutečné obchodní vůli, a o viditelnosti v AI rozhodujte jinými nástroji. U e-shopu to znamená povolit vše a hlídat, že vás robots.txt nikde neblokuje.
Co AI roboty skutečně řídí
Kdo chce o přístupu AI k webu opravdu rozhodovat, má k dispozici nástroje, které velké systémy prokazatelně respektují.
Zkontrolovat, že AI roboty neblokujete
U e-shopu chcete mít přístup otevřený pro Googlebot, Bingbot i vyhledávací roboty AI. Hledejte v robots.txt řádky, které je vypínají.
Zakázat jen trénink Gemini
Token Google-Extended řídí použití obsahu pro trénink Gemini. Na vyhledávání ani na AI Overviews vliv nemá.
Zakázat trénovací roboty AI
OpenAI a Anthropic mají oddělené roboty pro trénink a pro vyhledávání. Zakázat jde jen trénink a vyhledávání nechat otevřené.
Vyřadit web z AI funkcí Googlu
Google pro to nabízí přepínač v Google Search Console. Web pak v AI Overviews ani AI Mode nebude vidět vůbec — pro e-shop to nedoporučujeme.
Skrýt jen část stránky
Pasáž, kterou nechcete v úryvcích ani v AI odpovědích Googlu, vyřadíte atributem přímo v HTML.
Opravdu chránit obsah
Placený nebo důvěrný obsah chrání přihlášení, ne robots.txt. Ten je jen prosba, kterou si přečte každý — i ten, kdo ji nedodrží.
Nastavení a kontrola ve 4 krocích
- 1
Rozhodněte podle typu webu
E-shop, služby a B2B: Povolit u všech tří polí. Vydavatel s autorským obsahem: Nepovolit jen u trénování. Placený obsah: Nepovolit u odpovědí AI i trénování.
- 2
Nastavte pole v administraci Shoptetu
V sekci Robots.txt vyberte hodnoty ve třech rozbalovacích polích nad editorem a uložte. Řádek Content-Signal do textového pole ručně nepište — vznikl by dvakrát.
- 3
Zkontrolujte výsledný soubor
Otevřete vasedomena.cz/robots.txt a ověřte, že řádek Content-Signal odpovídá vašemu výběru a že nikde není Disallow: / pro roboty, které chcete pustit. Pomůže i náš návod na test robots.txt.
- 4
Projděte robots.txt jednou za půl roku
AI firmy přidávají nové roboty a standardy se vyvíjejí. Při kontrole sledujte hlavně to, jestli se k Content Signals nepřihlásil někdo z velkých hráčů — pak začne volba v Shoptetu skutečně platit.
Nejčastější chyby z našich auditů
„Nepovolit“ jako ochrana proti AI
Řádek Content-Signal robota nezastaví. Kdo chce obsah opravdu chránit, potřebuje pravidla User-agent a u citlivého obsahu přihlášení.
Zakázané odpovědi AI na e-shopu
E-shop, který chce prodávat, si sám posílá signál, že v AI doporučeních být nechce. Dnes bez následků, po přijetí standardu se ztrátou.
„Vyhledávače: Povolit“ chápané jako souhlas s AI shrnutím
Podle definice se signál search AI shrnutí netýká. Bez povoleného ai-input chybí výslovný souhlas právě s AI odpověďmi.
Řádek ručně v textovém poli i v polích nahoře
V souboru pak stojí dva řádky Content-Signal, případně s rozpornými hodnotami. Nastavujte jen přes rozbalovací pole.
Zákaz Googlebotu místo Google-Extended
Kdo chce zakázat trénink Gemini a omylem zablokuje Googlebot, vypadne z celého vyhledávání Googlu včetně AI Overviews.
Zděděné „block all AI“ z roku 2023
Staré pravidlo blokuje i vyhledávací roboty AI, a e-shop tak v odpovědích chybí. Na signály v Shoptetu se pak už nikdo nedívá.
Časté dotazy
Ovlivní nastavení Content Signals moje pozice v Googlu?
Ne. Google podle své oficiální dokumentace řádek Content-Signal v robots.txt ignoruje. Pozice ani zobrazení v AI Overviews se tím nezmění, ať zvolíte cokoli.
Má smysl signály nastavovat, když je nikdo nečte?
Má smysl je nastavit správně, nebo nechat nenastavené. Škodit může jen chybná volba, která by začala platit, kdyby se standard prosadil. Nastavení zabere minutu a vyjadřuje vaši vůli pro budoucnost.
Jaký je rozdíl mezi „Nepovolit“ a „Nenastaveno“?
„Nepovolit“ zapíše výslovný nesouhlas s daným použitím obsahu. „Nenastaveno“ hodnotu z řádku vypustí a nevyjadřuje nic — ani souhlas, ani zákaz. Pokud jsou nenastavená všechna tři pole, řádek Content-Signal v robots.txt vůbec nebude.
Ochrání „ai-train: Nepovolit“ moje texty před AI?
Technicky ne — robot se k textům dostane dál. Právně jde o možnou strojově čitelnou výhradu vytěžování textů a dat podle § 39c autorského zákona, zda ji soud jako takovou uzná, ale zatím nikdo neposuzoval. Kdo chce trénink spolehlivě omezit, doplní i pravidla pro trénovací roboty jako GPTBot nebo Google-Extended. Pro konkrétní právní posouzení se obraťte na advokáta.
Jak zařídím, aby mě AI nástroje doporučovaly?
Signály v robots.txt k tomu nepomohou. Rozhoduje, jestli k webu mají vyhledávací roboti přístup, jestli obsah odpovídá na otázky zákazníků konkrétně a jestli se o značce píše i jinde. To je práce, které se říká GEO.
Nevíte, jestli váš robots.txt nepouští AI pryč?
Projdeme robots.txt vašeho e-shopu, nastavení Content Signals v Shoptetu i pravidla pro AI roboty a řekneme rovnou, co vás v AI odpovědích drží zpátky. Bez závazku.
Termín si vyberete v kalendáři.
Zdroje
- CLOUDFLARE. Giving users choice with Cloudflare's new Content Signals Policy. The Cloudflare Blog [online]. 24. 9. 2025 [cit. 9. 10. 2026]. Dostupné z: https://blog.cloudflare.com/content-signals-policy/
- CLOUDFLARE. Managed robots.txt. Cloudflare Docs [online]. Aktualizováno 3. 8. 2026 [cit. 9. 10. 2026]. Dostupné z: https://developers.cloudflare.com/bots/additional-configurations/managed-robots-txt/
- GOOGLE. How Google interprets the robots.txt specification. Google for Developers [online]. Aktualizováno 31. 8. 2026 [cit. 9. 10. 2026]. Dostupné z: https://developers.google.com/crawling/docs/robots-txt/robots-txt-spec
- SCHWARTZ, Barry. Google: Cloudflare Content Signals Robots.txt Directive Has No Effects. Search Engine Roundtable [online]. 6. 7. 2026 [cit. 9. 10. 2026]. Dostupné z: https://seroundtable.com/google-cloudflare-content-signals-41631.html
- IETF AIPREF WORKING GROUP. A Vocabulary For Expressing AI Usage Preferences. Internet-Draft draft-ietf-aipref-vocab-08 [online]. 14. 9. 2026 [cit. 9. 10. 2026]. Dostupné z: https://datatracker.ietf.org/doc/html/draft-ietf-aipref-vocab-08
- MENČÍK, Jaroslav. Vytěžování veřejně dostupných autorských děl pro účely trénování umělé inteligence. epravo.cz [online]. 3. 10. 2024 [cit. 9. 10. 2026]. Dostupné z: https://www.epravo.cz/top/aktualne/vytezovani-verejne-dostupnych-autorskych-del-pro-ucely-trenovani-umele-inteligence-118625.html
- GOOGLE. Optimizing your website for generative AI features on Google Search. Google Search Central [online]. Aktualizováno 10. 7. 2026 [cit. 9. 10. 2026]. Dostupné z: https://developers.google.com/search/docs/fundamentals/ai-optimization-guide
Podpora Content Signals se může rychle měnit — stav v článku odpovídá říjnu 2026. Právní výklad § 39c autorského zákona ve vztahu ke Content Signals zatím nebyl soudně posouzen; článek nenahrazuje právní poradenství.